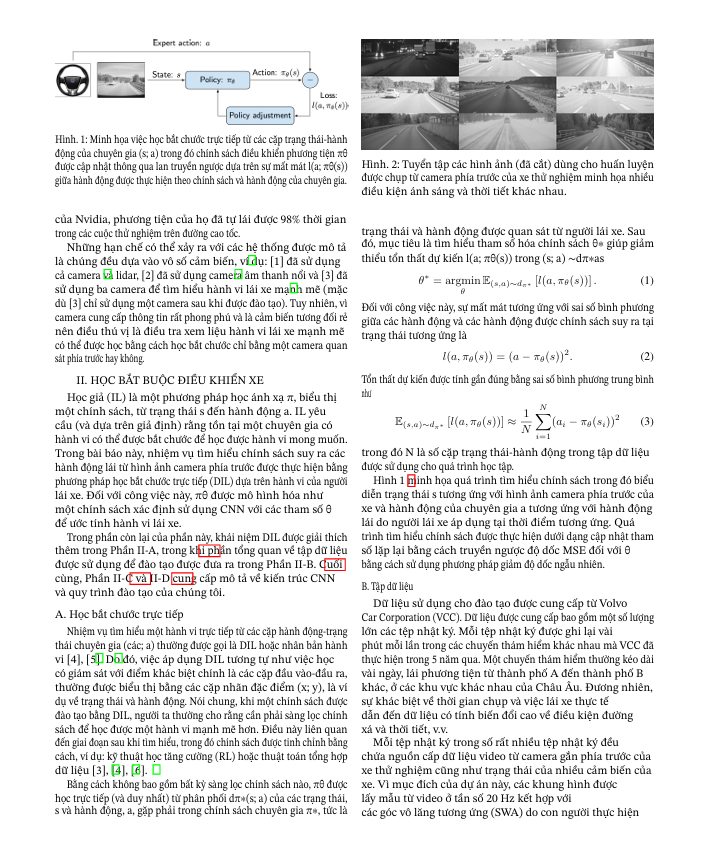
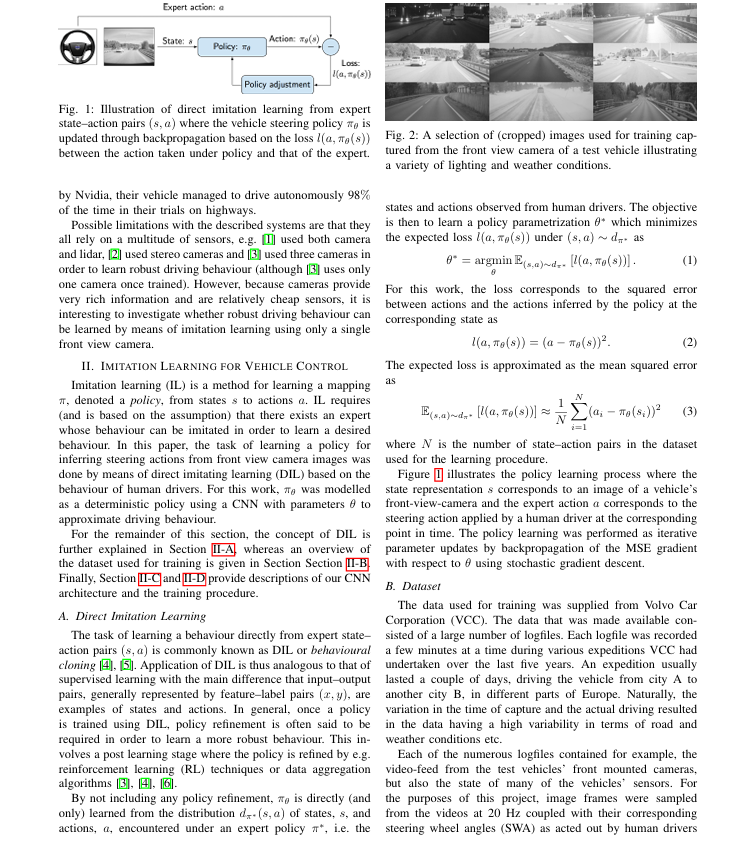
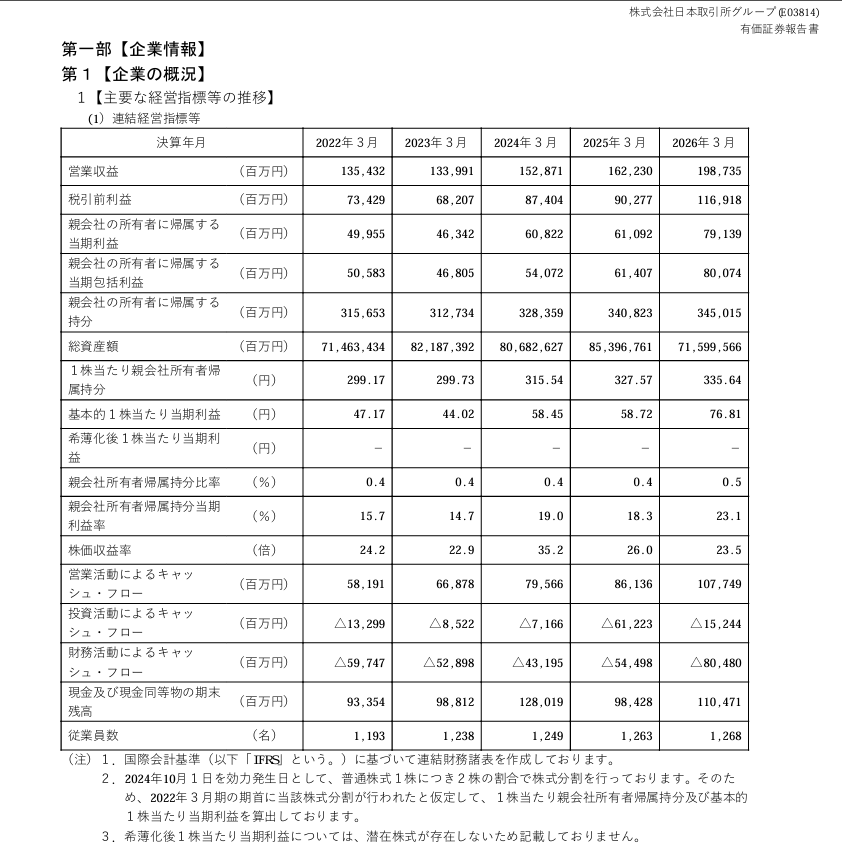
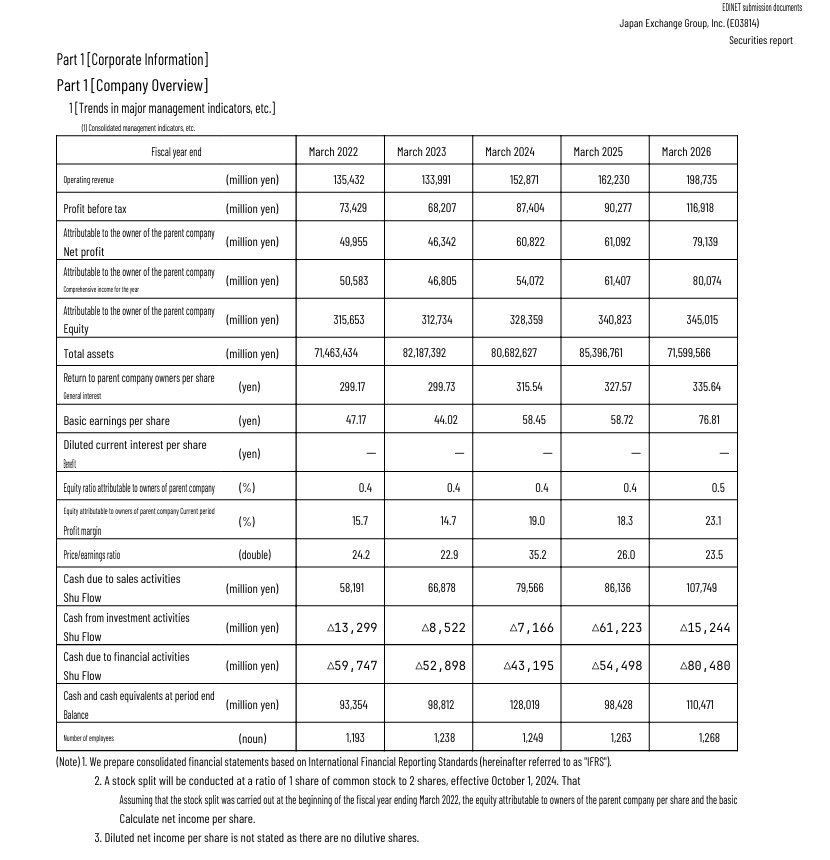
Vous cherchez un moyen de traduire un document PDF dans la langue de votre choix tout en préservant la mise en page, la police et la position des images comme dans l'original ?
Il s'agit d'un problème courant lorsque l'on travaille avec des articles universitaires, des rapports, des contrats ou des documents contenant de nombreux tableaux. Si vous extrayez simplement tout le texte, le traduisez et reconstruisez le PDF, la mise en page d'origine est facilement détruite.
Dans cet article, nous examinerons pourquoi les PDF perdent leur formatage après la traduction et comment les traiter en mettant l'accent sur la préservation de la structure du document.
Essayez l'outil de traduction de PrivatePDF
Traitez des documents directement dans votre navigateur avec une interface simple, en vous concentrant sur la préservation de la mise en page du fichier d'origine.
TRADUIRE LE PDF MAINTENANTPourquoi la plupart des outils de traduction PDF détruisent-ils le formatage ?
Le format PDF (Portable Document Format) est conçu principalement pour conserver la même apparence des documents sur différents appareils. Il ne fonctionne pas comme un document Word avec des concepts simples tels que des paragraphes, des colonnes ou des lignes.
À l'intérieur d'un PDF, la position du contenu est généralement décrite par des coordonnées. Lorsque le texte est traduit dans une autre langue, la longueur de la phrase change. Si un outil prend simplement du texte brut et essaie de le remettre en place, le texte peut déborder, se chevaucher ou se déplacer de sa position d'origine.
Étapes pour traduire un PDF tout en conservant la mise en page
- Étape 1 : Ouvrez l'outil. Accédez à la page Traduire PDF de PrivatePDF.
- Étape 2 : Téléverser un fichier. Faites glisser et déposez le fichier PDF dans la zone de téléversement et attendez que le système lise le document.
- Étape 3 : Sélectionnez la langue. Choisissez la langue cible que vous souhaitez utiliser pour la traduction.
- Étape 4 : Traduire et télécharger. Lancez le processus de traduction, examinez les résultats et téléchargez le fichier PDF sur votre appareil.
Combien de langues peuvent être traduites ?
La réponse courte est : N'importe quelle langue au monde ! Grâce à notre technologie de base, le système peut traduire autant de langues que le modèle sous-jacent en connaît.
Version de bureau : IA locale et multiples options de traduction
Pour les utilisateurs qui ont besoin de traiter des documents fréquemment, PrivatePDF Desktop pourrait être un meilleur choix pour les tâches nécessitant un traitement direct sur un ordinateur.
- Intégration d'IA diversifiée : la version de bureau intègre diverses IA intelligentes telles que ChatGPT, Gemini, DeepL,... pour améliorer la qualité de la traduction. De plus, elle comprend une IA locale qui permet une traduction de documents entièrement hors ligne et hautement sécurisée.
- Outils multiples : choisissez la méthode de traduction qui correspond le mieux à chaque type de document.
- Polices personnalisées : permet d'ajuster les polices après traduction pour mieux répondre à vos besoins.
Bureau PrivatePDF
Logiciel de traduction dédié avec plus d'options pour vos besoins de traduction.
TÉLÉCHARGER L'APPLICATIONPourquoi la sécurité est-elle importante lors de la traduction d'un PDF ?
Si votre document contient des informations internes, des contrats, des rapports ou des données non publiées, choisir comment traiter le fichier est une considération importante.
- Traitement dans le navigateur : selon la description de PrivatePDF, les outils Web sont conçus pour traiter les fichiers directement dans le navigateur pour les fonctionnalités prenant en charge le traitement local.
- Aucune inscription requise : les utilisateurs peuvent utiliser les outils sans créer de compte pour les opérations prises en charge.
- Dépendant de l'appareil : lors du traitement local, la vitesse et les limites réelles dépendent de la mémoire et de la puissance de votre ordinateur.
Les PDF numérisés peuvent-ils être traduits ?
Pour les PDF numérisés, vous avez seulement besoin d'un outil OCR pour extraire le texte avant la traduction. Cependant, le résultat de la traduction dépend fortement de la qualité du fichier d'origine.
Si la qualité de la numérisation est bonne, le modèle OCR reconnaîtra parfaitement le texte et fournira une traduction précise. À l'inverse, si le fichier est trop flou ou de mauvaise qualité, le système peut mal reconnaître les caractères ou produire un texte illisible.